Reportes de conversaciones
Los reportes de conversaciones muestran cómo viene la operación: volumen, tiempos, consumo de mensajes, comportamiento del bot y de los agentes. Todo sale de datos reales de la plataforma y respeta el rango de fechas y los filtros aplicados.
Cómo usar esta guía
Cada reporte del panel lleva un código corto tipo KR-SUM-03 al lado del título, y un signo ? que trae directo a la sección de ese código en esta página.
Barra de controles
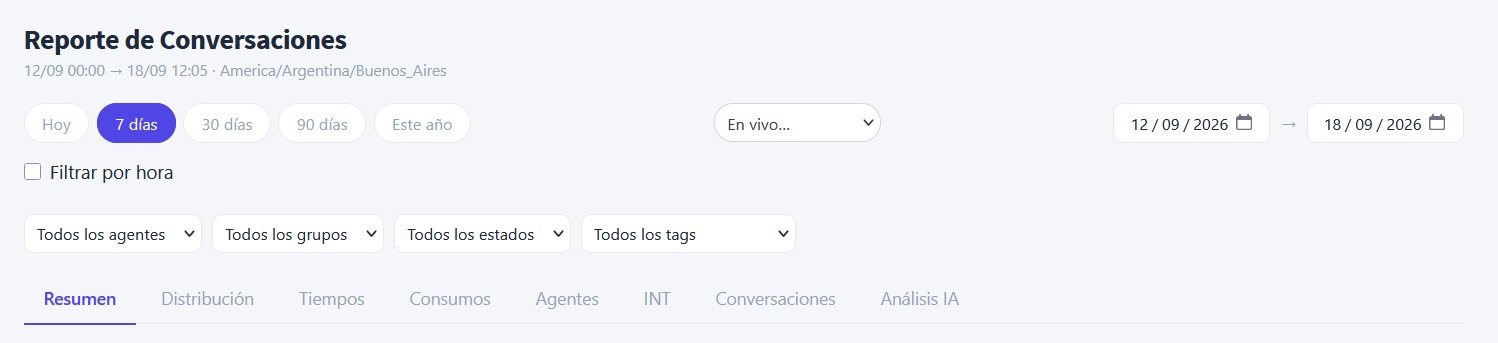
Arriba de todo se define qué y cuándo analizar. La primera línea muestra el rango efectivo y la zona horaria de la empresa. Debajo existen:
- Selecciones rápidas: Hoy, 7 días, 30 días, 90 días, Este año, y un selector En vivo… (5 min, 15 min, 1 hora, hoy hasta ahora) para mirar el momento presente.
- Rango a medida: las dos fechas de la derecha, y Filtrar por hora para acotar a una franja horaria dentro de cada día.
- Filtros globales: agente, grupo, estado y tag. Se aplican a todos los reportes a la vez.
Rango vs. momento
La mayoría de los reportes se calculan sobre el rango elegido. Unos pocos son foto del momento presente (estado actual) y no dependen del rango: se aclara en cada uno con la leyenda al momento.
Resumen
Resumen general
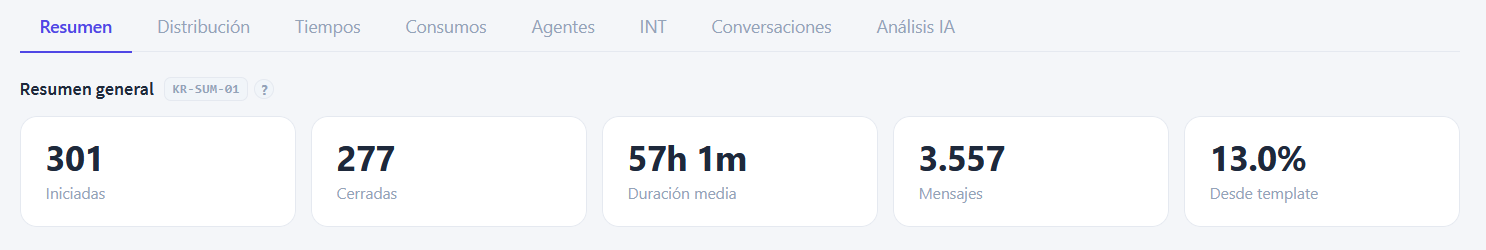
Los números de cabecera del rango: Iniciadas (conversaciones que arrancaron), Cerradas, Duración media de atención, Mensajes (entrantes + salientes) y Desde template (qué porcentaje de las conversaciones arrancó porque la empresa mandó un template, no porque el cliente escribió primero).
Se leen como el pulso general del período. Un "Desde template" alto indica una operación que sale a buscar al cliente (campañas, recontactos) más que una que solo responde. La duración media incluye conversaciones largas que quedaron abiertas varios días, así que hay que tomarlas como referencia, no como el tiempo de una conversación promedio.
Eficacia del bot

Mide cuánto trabajo real se alivia con el bot. Arriba, los KPIs: Contención (parte que el bot resolvió y cerró sin humano), Derivación a humano, volumen de salientes del bot vs de agentes, y el % saliente automático. Abajo, un ranking de mensajes salientes por origen: primero el Bot, después cada agente, con una barra proporcional.
La contención alta es buena señal de automatización efectiva. El ranking de abajo sirve para lo contrario a lo que parece: si un agente concentra muchísimos salientes, puede estar haciendo a mano algo que convendría automatizar, o simplemente cargando con la mayor parte de las conversaciones.
Flujo de conversaciones
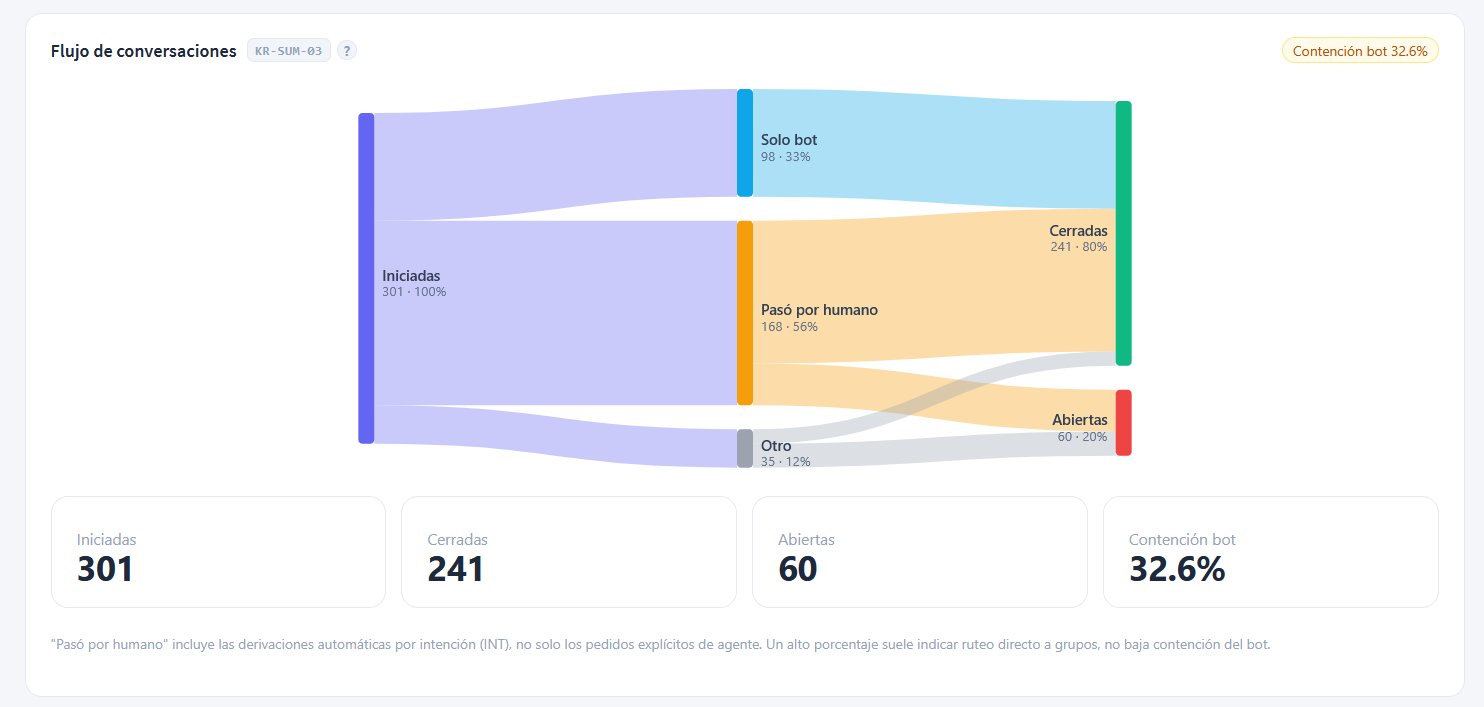
Un embudo del recorrido de cada conversación, de izquierda a derecha: Iniciadas → (Solo bot / Pasó por humano / Otro) → (Cerradas / Abiertas). El ancho de cada franja es proporcional al volumen, y cada nodo muestra su total y su porcentaje. El indicador Contención bot arriba a la derecha es la parte que el bot cerró solo. Es determinístico: se arma del recorrido real de cada ticket, sin IA.
Se lee siguiendo el grosor de las franjas. Mucho caudal por "Solo bot → Cerradas" es automatización sana. Mucho por "Pasó por humano" no es necesariamente negativo, pero conviene entender por qué (ver la nota). La franja "Otro" son conversaciones sin recorrido claro (el bot atendió sin cerrar ni derivar).
Cómo leer 'Pasó por humano'
Incluye las derivaciones automáticas por intención (INT), no solo cuando el cliente pide un agente. Una empresa que rutea casi todo por INT hacia grupos va a ver un "Pasó por humano" alto aunque el bot esté clasificando perfecto. Un porcentaje alto suele indicar ruteo directo a grupos, no baja contención del bot.
Por agente
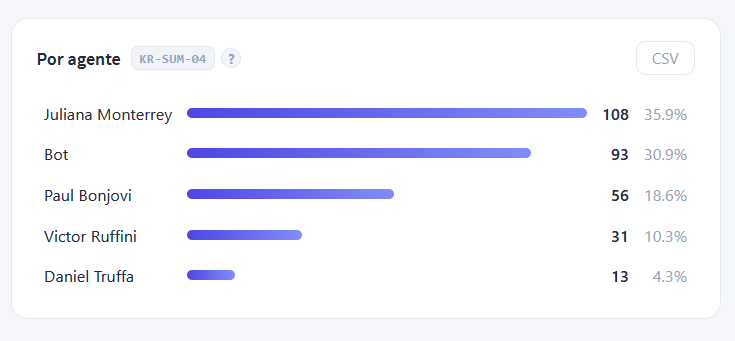
Cuántas conversaciones atendió cada agente en el rango, de mayor a menor, con la cuenta y el porcentaje sobre el total. El Bot aparece como un "agente" más, así se identifica cuánto resolvió la automatización frente a los agentes.
Sirve para dimensionar carga y detectar desbalance: un agente muy por encima del resto puede estar sobrecargado, o ser el único cubriendo un turno.
Por grupo
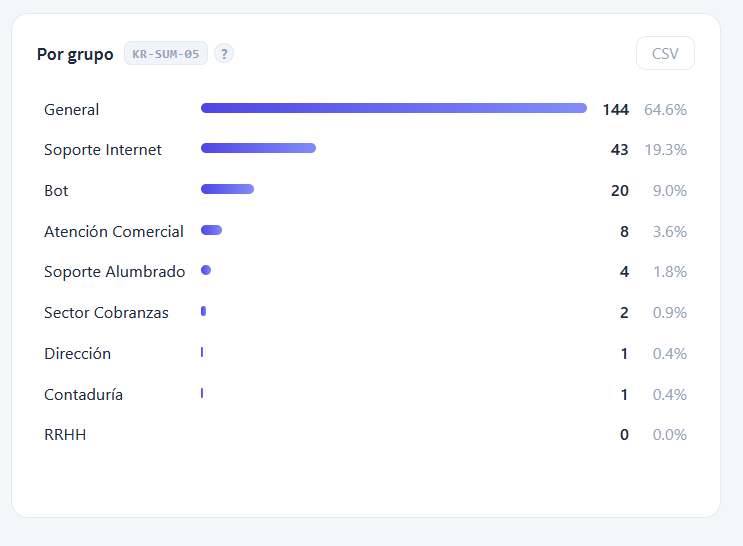
Lo mismo que el anterior pero por grupo de atención (General, Soporte, Cobranzas, etc.). Muestra hacia dónde se va el volumen dentro de la estructura de la empresa.
Un grupo que se lleva la mayoría del tráfico es candidato a reforzar; uno en cero puede ser un grupo mal ruteado o directamente sin uso.
Estado ahora
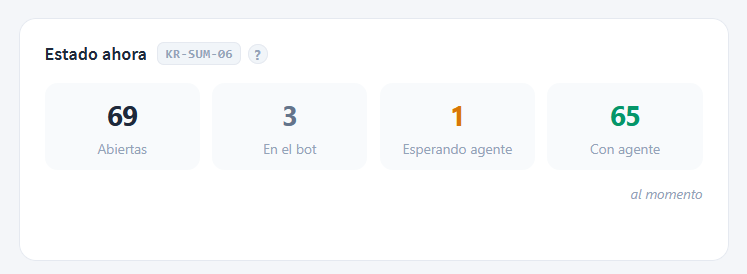
Foto del momento presente, no del rango. De las conversaciones abiertas ahora mismo: cuántas hay Abiertas en total, cuántas están En el bot, cuántas Esperando agente (ya en un grupo, sin que nadie las tome) y cuántas Con agente.
Es una lectura operativa de "cómo es la situación en este instante". El número a vigilar es Esperando agente: si crece, hay clientes en espera sin atención.
Estado de atención
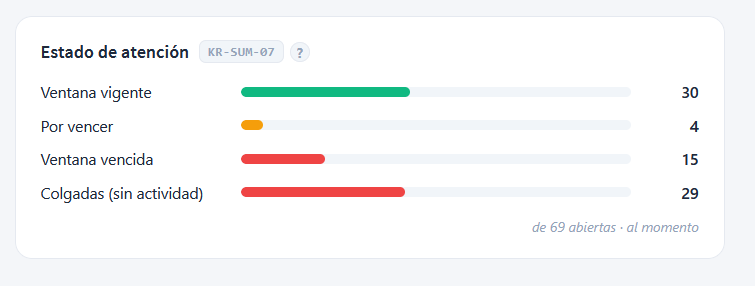
También foto del momento. De las conversaciones abiertas ahora, en qué situación está la ventana de 24 h de Meta: Vigente (verde, se puede responder libremente), Por vencer (naranja, quedan pocas horas), Ventana vencida (rojo, ya no se puede responder sin template) y Colgadas (rojo, abiertas sin actividad hace tiempo). El pie aclara sobre cuántas abiertas se calcula.
Es el bloque de gestión de conversaciones. Por vencer son las urgentes: responder antes de que se cierre la ventana. Ventana vencida y Colgadas son conversaciones que quedaron sin resolver y conviene cerrar o recontactar con template.
Distribución
Mapa de calor · día × hora
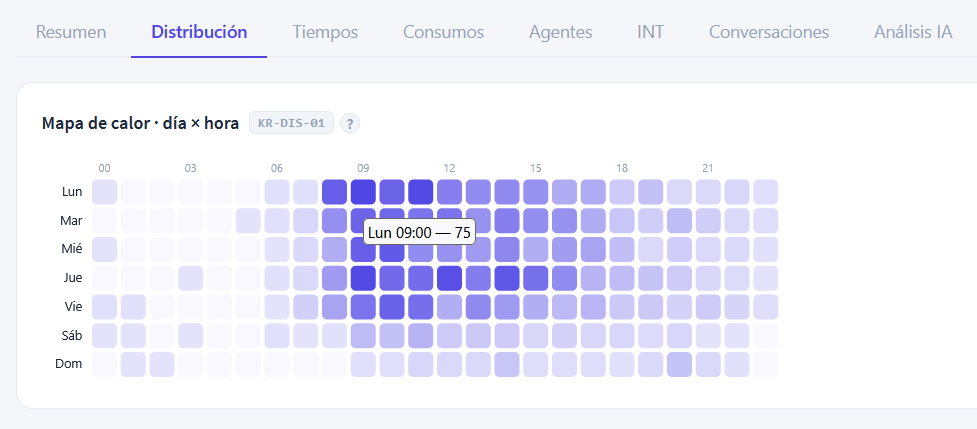
Una matriz de 7 días × 24 horas. Cada celda es un día de la semana y una hora; cuanto más oscura, más conversaciones cayeron en esa franja. Al pasar el mouse, el tooltip muestra el valor exacto (por ejemplo, Lun 09:00 - 75).
Se lee buscando las manchas oscuras: ahí se encuentran los picos de demanda. Sirve directo para dimensionar turnos y decidir en qué franjas hace falta más gente o dónde el bot tiene que gestionar solo.
Conversaciones por hora
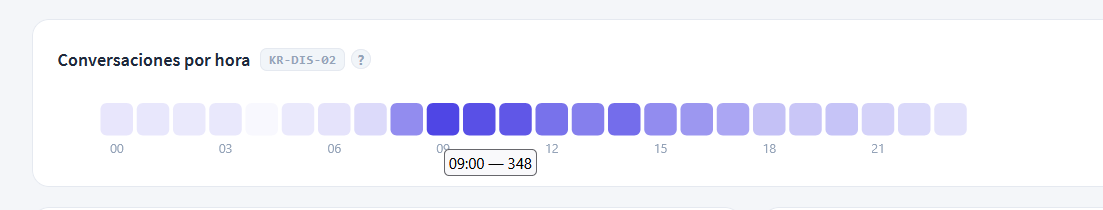
La misma lectura del mapa de calor pero colapsada a las 24 horas del día, sin abrir por día de semana. Una tira de celdas de 00 a 23; más oscuro, más volumen. El tooltip da el total por hora (por ejemplo, 09:00 - 348).
Útil cuando solo importa la curva horaria promedio: a qué hora abre la demanda, dónde está el pico, cuándo baja.
Por día de la semana
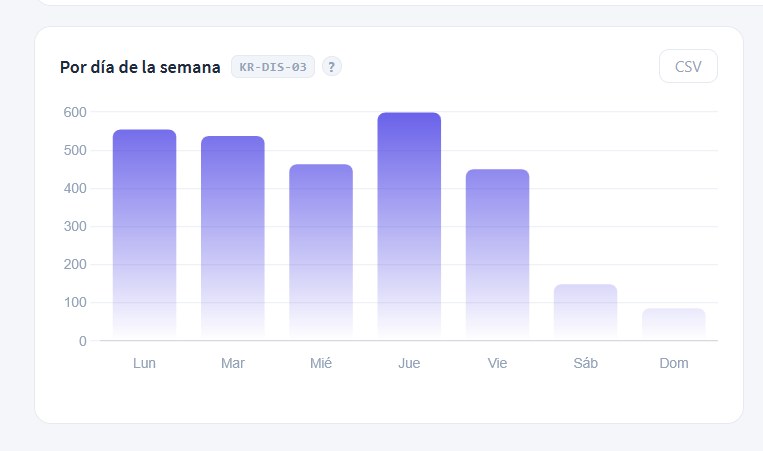
Un gráfico de barras con el volumen total de conversaciones por día, de lunes a domingo.
Muestra el patrón semanal: qué días concentran la carga y cuánto cae el fin de semana. Ayuda a planificar cobertura y campañas (mejor no lanzar un envío grande el día de mayor demanda espontánea).
Por motivo / tag
Distribución de conversaciones según la etiqueta que se les asignó, en barras horizontales.
Es la lectura de "por qué escriben". Requiere asignación de TAGs por parte de los agentes luego de una conversación. Concentración en pocas etiquetas dice dónde poner foco (más automatización, más gente, mejores respuestas).
Empresa sin etiquetas
Si la empresa no usa tags, este bloque aparece vacío (como en la captura). No es un error: no hay nada que distribuir. Lo mismo vale para el filtro por tag de la barra de controles.
Tiempos
El tab de Tiempos mide el SLA de toma: cuánto espera una conversación desde que entra a un grupo hasta que un agente la toma y responde. Solo cuenta las que llegaron a un agente humano; lo que resolvió el bot no entra acá.
Tiempo de toma (SLA)
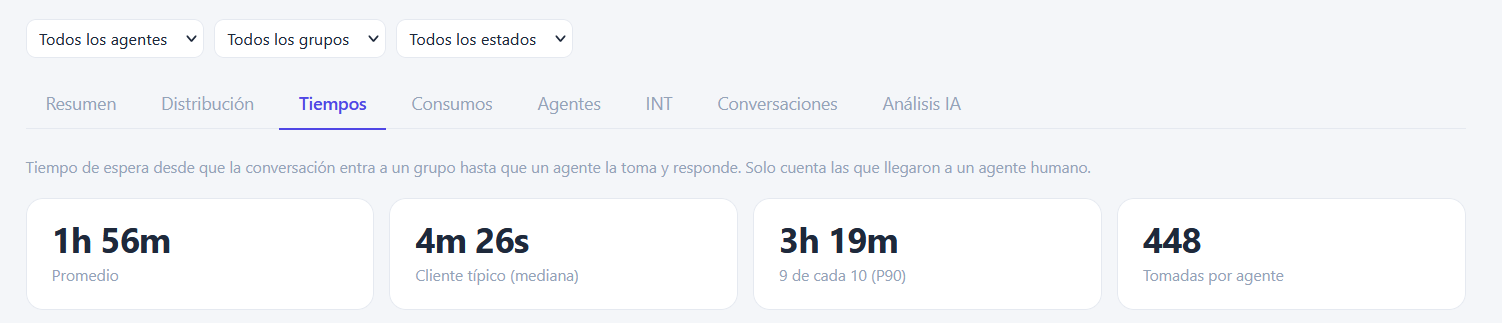
Los cuatro números de cabecera: Promedio (lo incrementa algún caso extremo, tomar con reserva), Cliente típico (mediana) - la mitad esperó menos que lo indicado, 9 de cada 10 (P90) -el peor caso realista, el 90% esperó menos- y Tomadas por agente (cuántas conversaciones entraron en el cálculo).
La lectura honesta es mediana + P90, no el promedio. La mediana indica la experiencia habitual; el P90, cuán malo se pone en los peores casos. Si la mediana es baja pero el P90 alto, la mayoría se atiende rápido pero hay casos que quedan mucho tiempo esperando.
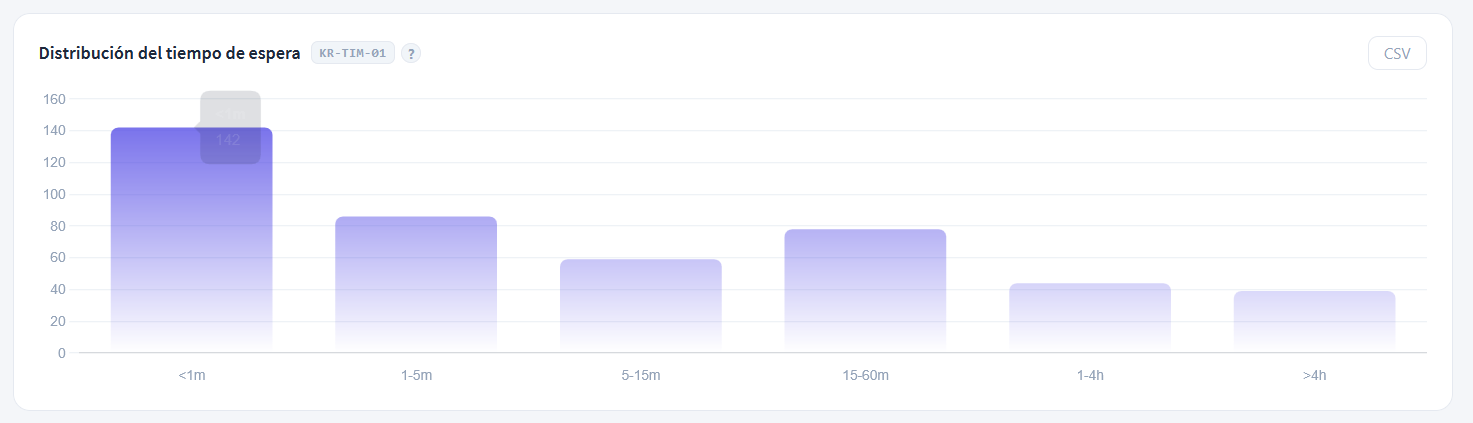
El histograma reparte las conversaciones en tramos de espera (<1m, 1-5m, 5-15m, 15-60m, 1-4h, >4h). Cuanto más cargado esté a la izquierda, mejor: la mayoría se toma rapidamente. Indicadores altos hacia la derecha (>4h) son clientes que esperaron demasiado.
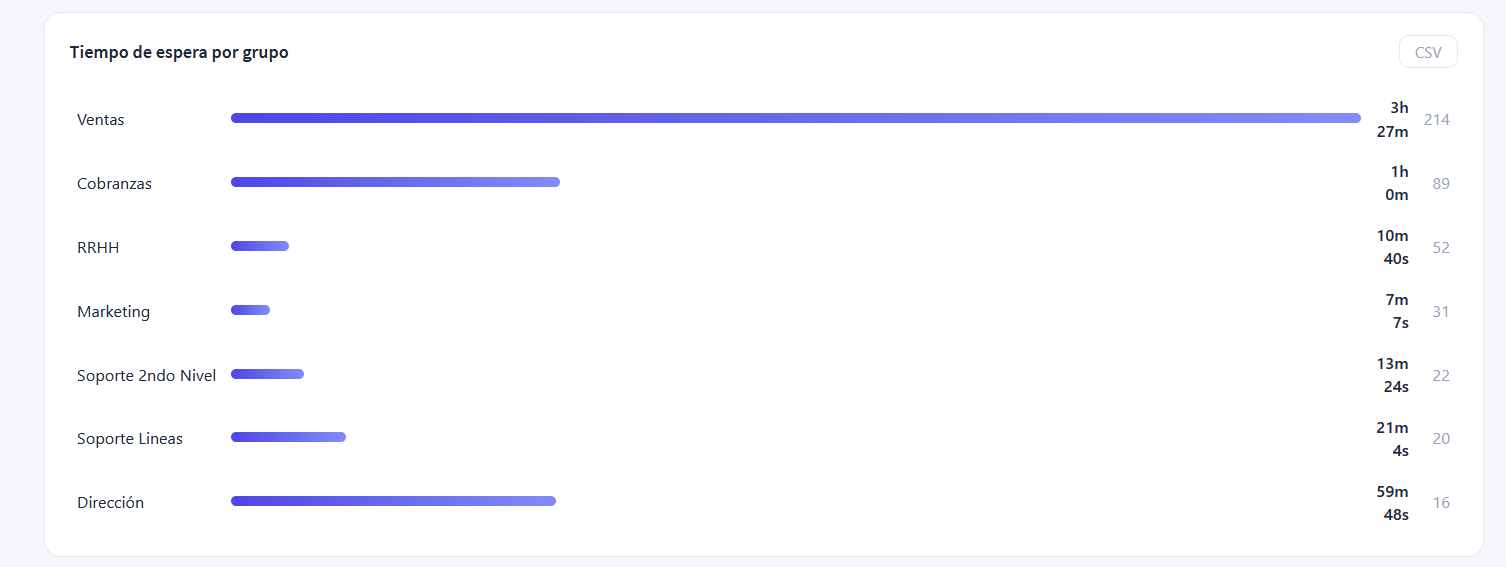
El mismo tiempo de espera abierto por grupo, con la espera promedio (la barra y el tiempo) y la cantidad de conversaciones tomadas (el número gris a la derecha). Sirve para ubicar dónde está el cuello de botella: un grupo con espera muy por encima del resto necesita más gente o mejor ruteo. Atención en cruzar espera y volumen: una espera alta sobre pocos casos pesa distinto que sobre muchos.
Exactitud de mediana y P90
Son exactos cuando el rango entra en modo "en vivo" (rangos cortos). En rangos largos que leen el histórico agregado no hay valores crudos guardados: la mediana cae a un valor aproximado por tramos y el P90 no está disponible.
Seguimiento
Recontacto y abandono del cliente sobre el rango: recontactos (conversaciones reabiertas), abandonos (el cliente dejó de responder) y transferencias, cada uno con su porcentaje.
Es la lectura de "qué pasó después". Muchos abandonos pueden indicar respuestas lentas o flujos que no resuelven; muchos recontactos, una operación que trabaja bien el seguimiento.
Consumos
Qué mide Consumos
Volumen de mensajes que genera costo en Meta. Servicio = salientes que no son template (Meta los cobra como servicio desde octubre 2026). Templates = campañas + envíos manuales de agentes para reabrir conversación.
Consumos
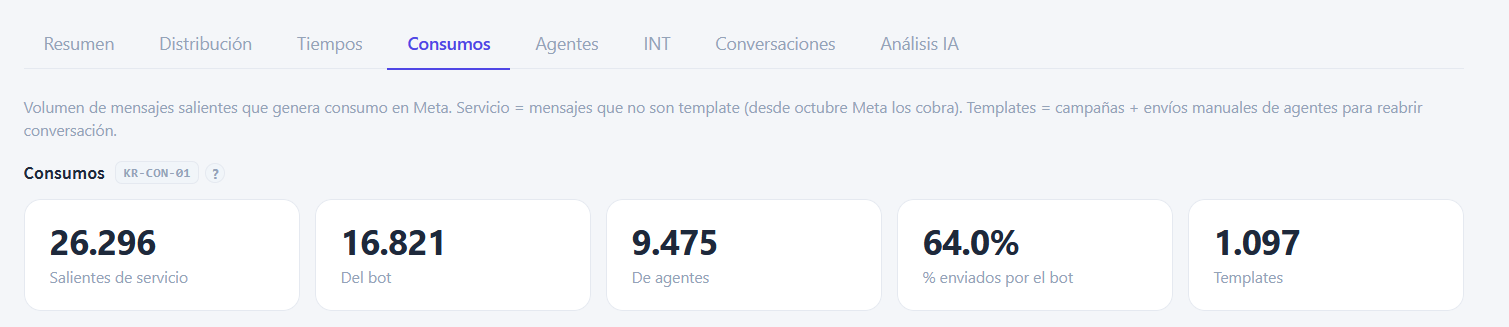
Los totales del rango: Salientes de servicio (total), cuántos mandó el bot, cuántos los agentes, el % enviado por el bot y el total de Templates.
Se lee como el volumen que dispara costo. El total de templates es aparte porque tiene otra tarifa y otra lógica (campañas y recontactos).
Salientes de servicio por día
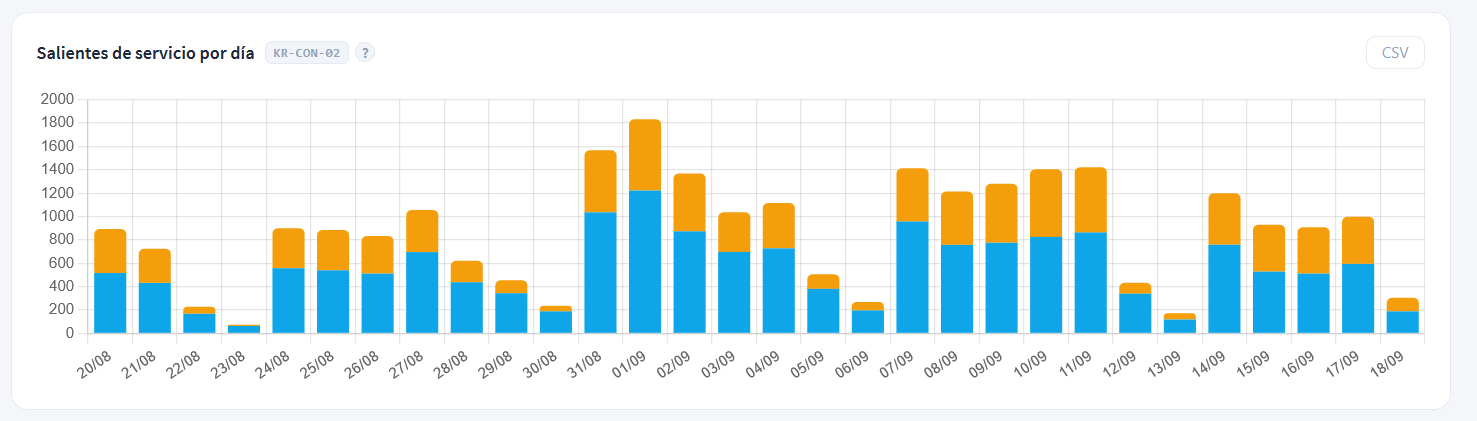
Serie diaria de salientes de servicio, en barras apiladas: bot (celeste) abajo, agentes (naranja) arriba. Cada barra es un día del rango.
Muestra la tendencia y quién genera el volumen día a día. Picos coordinados con campañas o eventos son esperables; un escalón sostenido de la parte naranja dice que los agentes están enviando cada vez más a mano.
Salientes de servicio por agente
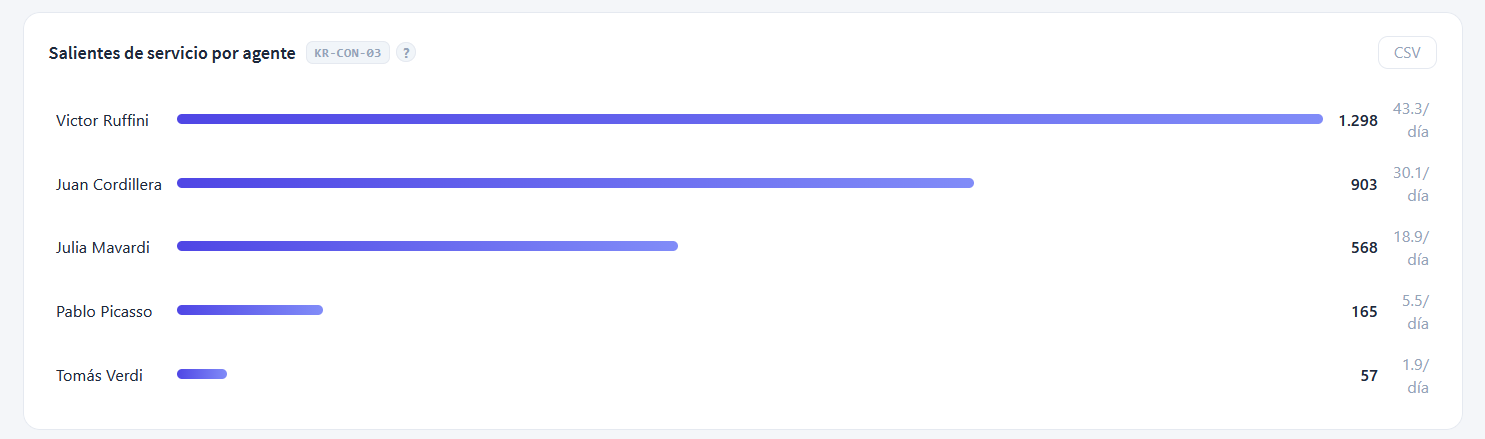
Ranking de salientes de servicio por agente, con el total del rango y el promedio por día a la derecha. El promedio por día se calcula sobre todos los días del rango, permite comparar equivalente aunque un agente haya trabajado más días que otro.
Sirve para ver quién carga con el volumen y detectar desbalances. Un promedio diario muy alto puede ser productividad real o falta de automatización en la conversaciones de ese agente.
Templates por día
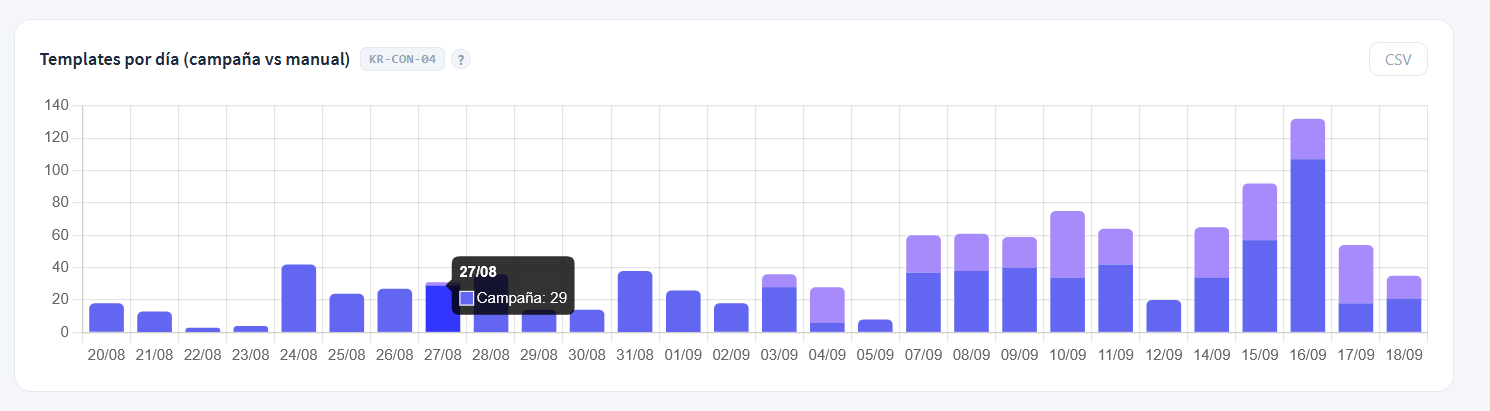
Templates enviados por día, apilados entre Campaña y Manual. Campaña son los envíos masivos programados; Manual son los recontactos que un agente dispara para reabrir una conversación fuera de la ventana de 24 h.
Separar los dos importa porque tienen orígenes distintos: la parte de campaña la controla marketing; la manual, la operación. Un pico de manual sostenido puede indicar muchas conversaciones que se dejaron vencer y hay que reabrir.
Templates manuales por agente
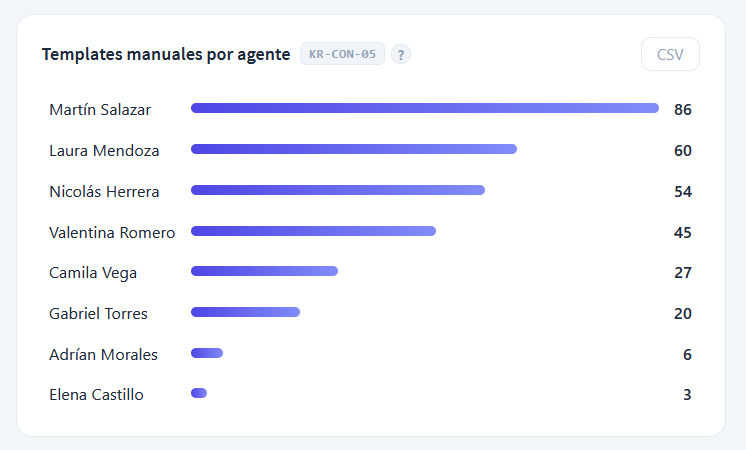
Ranking de cuántos templates manuales (recontactos) envió cada agente en el rango.
Muestra quién reabre más conversaciones. Números altos pueden ser buen seguimiento o, al revés, señal de que a ese agente se le vencen muchas ventanas y las tiene que reabrir con template.
Campañas del rango
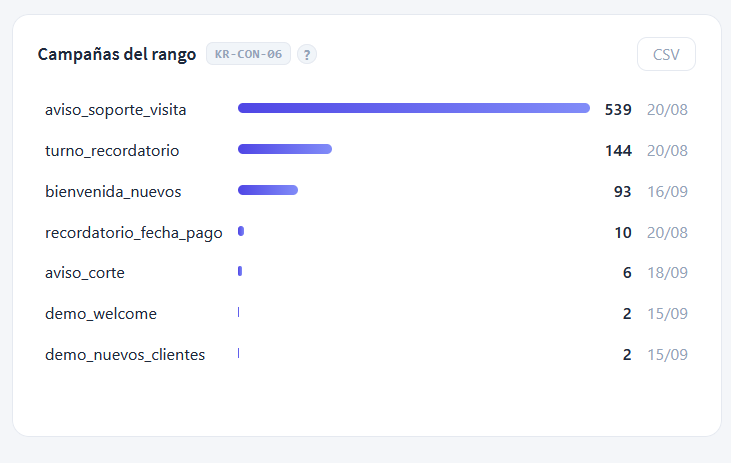
Las campañas que enviaron dentro del rango, con su volumen y la fecha del primer envío. Es la contracara "por campaña" del bloque de templates: qué campañas concretas movieron más en el volumen.
Conversaciones
Listado de conversaciones
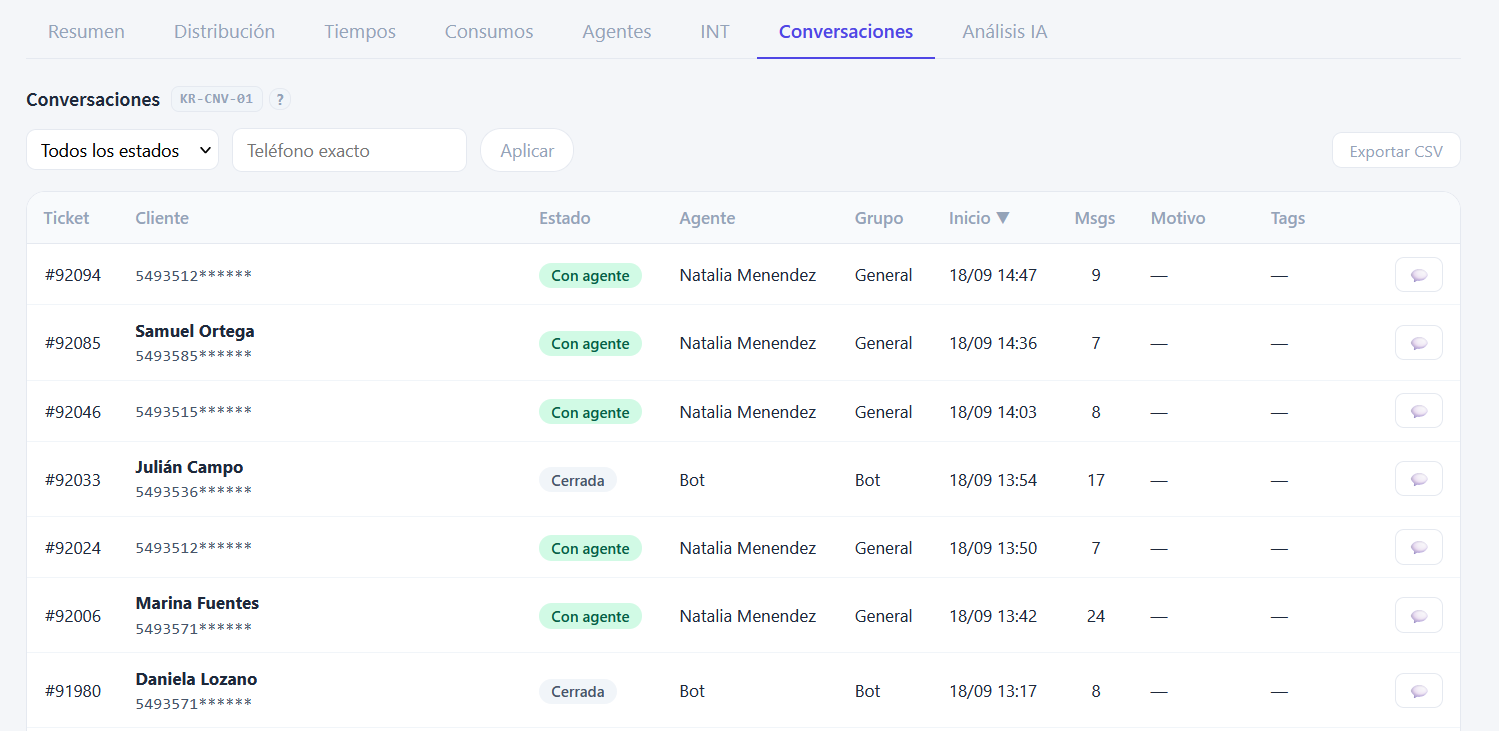
El detalle, conversación por conversación, del rango. Cada fila trae el número de ticket, el cliente (nombre si está en la agenda, si no el teléfono), el estado (En espera / Con agente / Cerrada), el agente y el grupo que la tienen, la hora de inicio, la cantidad de mensajes, el motivo y los tags. El ícono de la derecha abre el hilo completo, con su resumen IA.
Se filtra por estado y por teléfono exacto, y se ordena por las columnas. Es la vista para bajar de las estadísticas a los casos concretos: encontrar una conversación puntual, revisar por qué una quedó abierta, o auditar el trabajo sobre un cliente específico. El botón Exportar CSV baja el listado completo del rango.
Agentes
Actividad de agentes
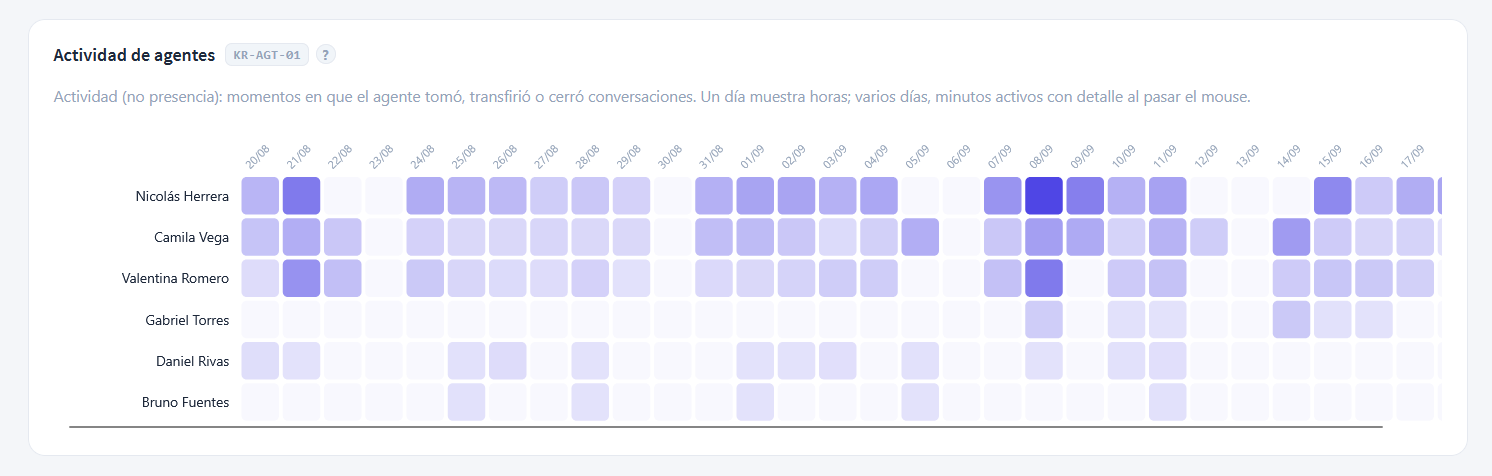
Una matriz de agentes × días. Cada celda marca la actividad de ese agente ese día -momentos en que tomó, transfirió o cerró conversaciones; más oscura, más actividad. Al pasar el mouse se ve el detalle (en un solo día, por horas; en varios, minutos activos).
Actividad, no presencia
Marca cuándo el agente actuó sobre conversaciones, no cuánto estuvo logueado. Una celda clara no significa "ausencia": puede haber estado disponible sin casos asignados. Se tiene que leer como intensidad de trabajo, no como control de asistencia.
Sirve para ver patrones: quién sostiene la operación día a día, quién trabaja a saltos, qué días quedó la cobertura insuficiente.
INT (detección de intención)
El tab de INT muestra cómo clasificó el motor de intención los mensajes de texto libre: cuántos entendió, cuántos cayeron sin coincidencia y qué pasó con los que no se pudieron derivar en el primer intento.
Resumen de clasificación
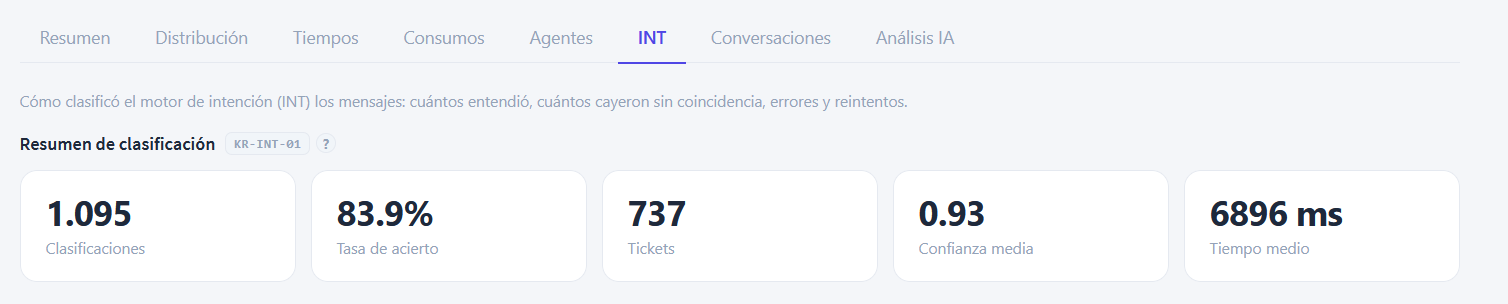
Los KPIs del motor: Clasificaciones (cuántos mensajes analizó), Tasa de acierto (qué porcentaje derivó a un destino), Tickets afectados, Confianza media (qué tan seguro quedó, de 0 a 1) y Tiempo medio de respuesta del motor.
La tasa de acierto es la métrica gruesa, pero subestima el resultado real: no cuenta que un mensaje que falló a la primera muchas veces se recupera al reintento (ver KR-INT-04). La confianza media y el tiempo medio son señales de salud: confianza baja sugiere descripciones de intención muy generales.
Resultado de la clasificación
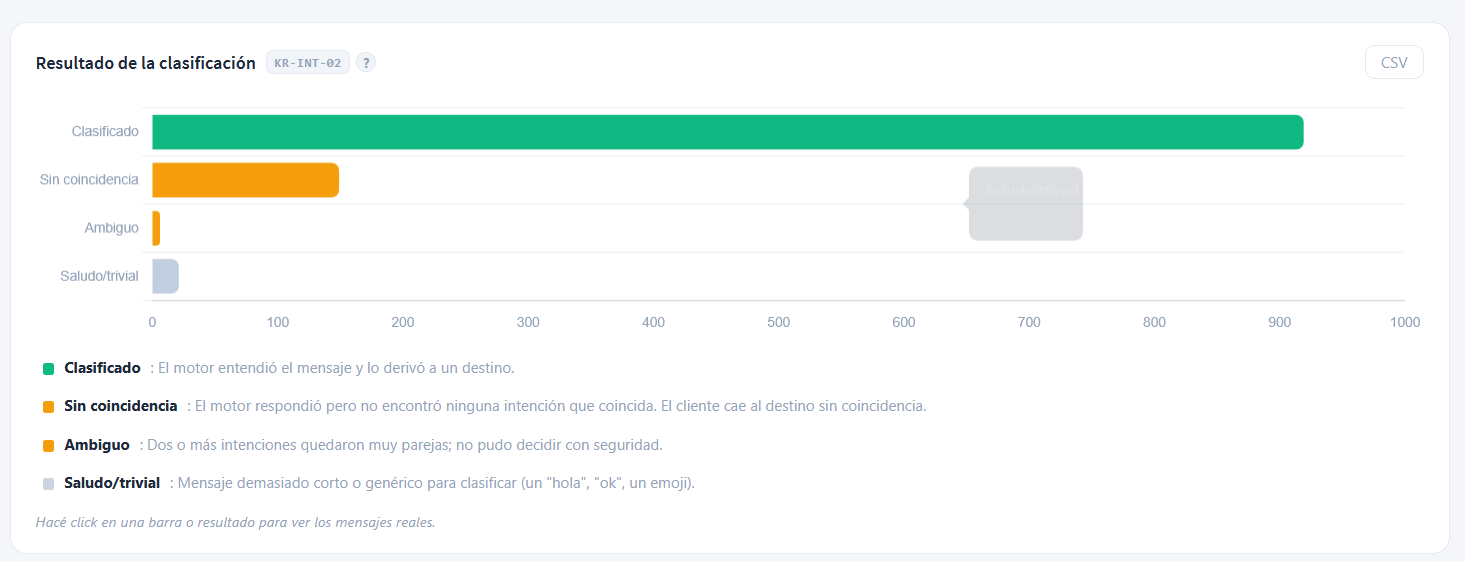
En qué terminó cada intento de clasificación, en barras horizontales por razón:
- Clasificado (verde): el motor entendió el mensaje y lo derivó a un destino.
- Sin coincidencia (naranja): respondió pero no encontró ninguna intención aplicable; el cliente cae al destino sin coincidencia (normalmente un grupo).
- Ambiguo (naranja): dos o más intenciones quedaron demasiado parejas y no se pudo decidir con seguridad.
- Saludo/trivial (gris): mensaje demasiado corto o genérico para clasificar (un "hola", "ok", un emoji).
Click en una barra para ver los mensajes reales que cayeron en esa categoría. La lectura clave es la proporción de naranja: mucho "Sin coincidencia" o "Ambiguo" apunta a un catálogo de intenciones incompleto o con descripciones que se solapan.
Por intención / item
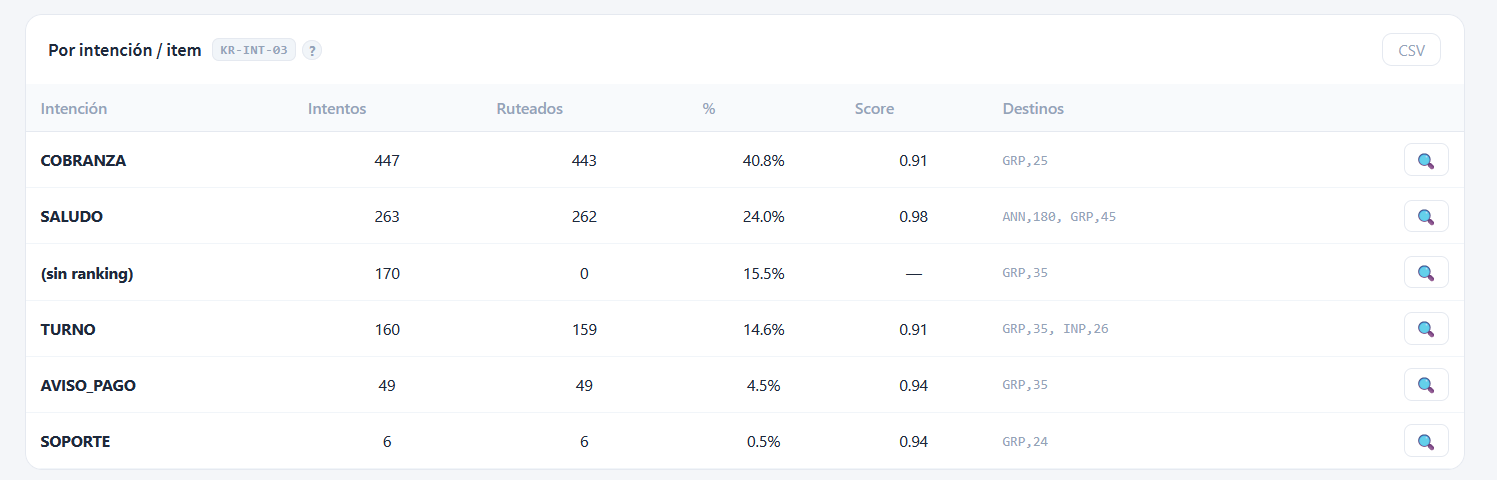
Una tabla con cada intención del catálogo: Intentos (cuántas veces se evaluó), Ruteados (cuántas veces ganó y derivó), % sobre el total, Score medio de confianza y los Destinos a los que mandó (en formato TIPO,ID, por ejemplo GRP,25). La lupa de la derecha abre los mensajes reales de esa intención.
Sirve para afinar el catálogo. Una intención con muchos intentos pero pocos ruteados no está aplicando correctamente: su descripción es vaga o se pisa con otra. La fila (sin ranking) son los mensajes que no matchearon ninguna intención: candidatos a sumar como intención nueva.
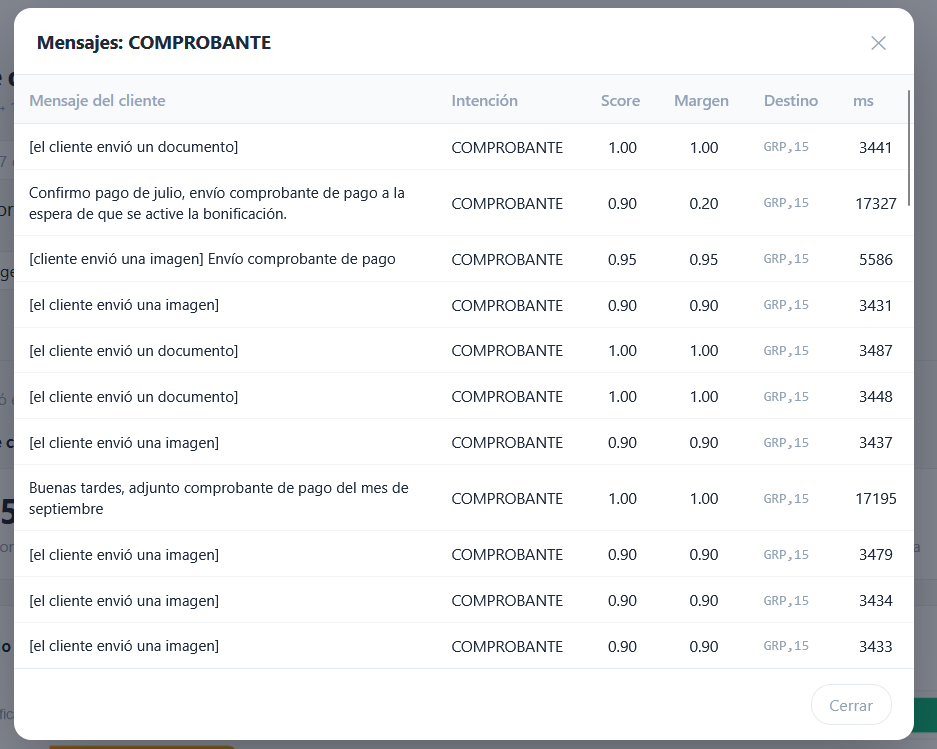
Al abrir la lupa se ve, mensaje por mensaje: el texto del cliente, la intención ganadora, el score, el margen contra la segunda opción, el destino y el tiempo del motor en ms. Es la evidencia cruda detrás del número, útil para entender por qué el motor decidió lo que decidió.
Reintento y recuperación
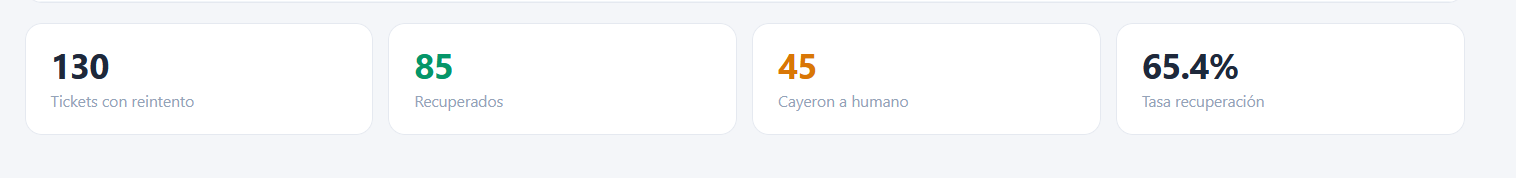
Qué pasó con los mensajes que no se entendieron a la primera: Tickets con reintento (donde hubo al menos un fallo), Recuperados (terminaron clasificando en un intento posterior), Cayeron a humano (agotaron los reintentos y se derivaron al destino sin coincidencia) y Tasa de recuperación.
Este bloque explica por qué la tasa de acierto cruda (KR-INT-01) engaña. El patrón típico es un cliente que escribe "hola" (no clasifica), y en el mensaje siguiente escribe lo que necesita (clasifica). Lo que importa operativamente no es cuántas clasificaciones fallaron, sino cuántos tickets terminaron sin entenderse y cayeron a un humano, esa es la columna a vigilar. Una tasa de recuperación alta significa que el motor se readapta solo y solicita menos al cliente.
Análisis IA
Estos reportes salen del análisis IA de las conversaciones cerradas. Puede que algunas conversaciones no estén todavía analizadas, así que cada bloque muestra un indicador de cobertura.
Cobertura
El cartel cobertura X% dice qué parte del rango tiene análisis disponible. Con cobertura baja, los porcentajes son orientativos: están calculados sobre la parte analizada, no sobre el total.
Emoción del cliente
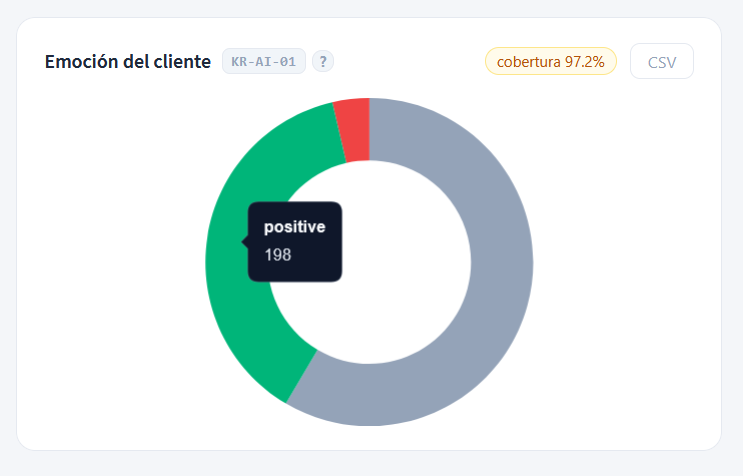
Distribución del tono detectado en las conversaciones, en anillo: positivo (verde), neutral (gris), negativo (rojo) y mezclas. El tooltip da el conteo por categoría.
Es un termómetro del clima de las conversaciones. Un salto en la porción negativa entre períodos merece mirarse junto con Motivo de contacto (KR-AI-03): suele coincidir con un problema puntual (una falla, un corte, un aumento).
Resolución
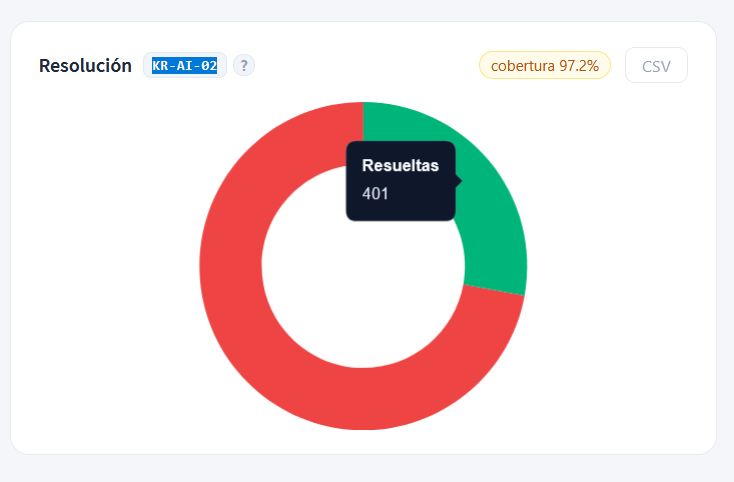
Proporción de conversaciones que el análisis marcó como Resueltas vs No resueltas, en anillo. El tooltip da el conteo.
Es una lectura de efectividad distinta al cierre operativo: una conversación puede estar cerrada en el sistema pero marcada como no resuelta por el análisis (el cliente se fue sin lo que buscaba). Una porción alta de no resueltas es señal de flujos o respuestas que no terminan de resolver.
Motivo de contacto (IA)
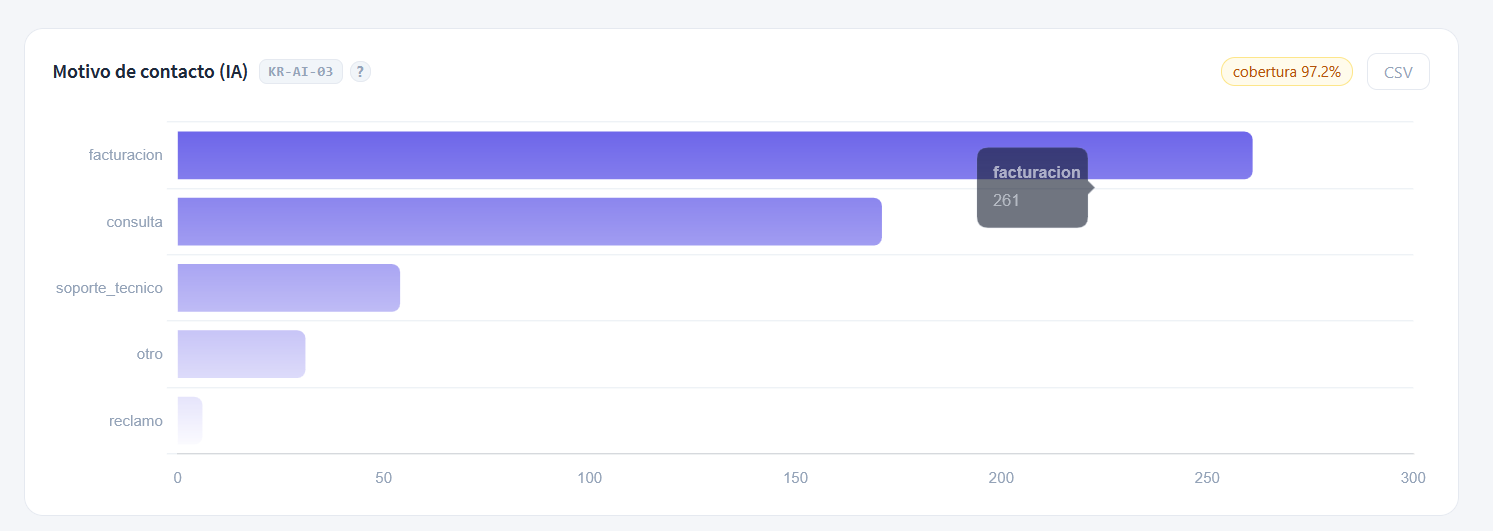
Los temas más frecuentes por los que escriben los clientes, según el análisis IA, en barras horizontales ordenadas por volumen (facturación, consulta, soporte técnico, etc.). El tooltip da el conteo por tema.
A diferencia de Por motivo / tag (KR-DIS-04), que depende de que los agentes etiqueten a mano, este sale del análisis automático, así que cubre incluso las conversaciones sin tag. Es la mejor lectura de "de qué habla la gente" y dónde conviene reforzar el bot o el catálogo de intenciones.